
Dengesiz Veri Setinde Doğruluk (Accuracy) Neden Yanıltır?
Dolandırıcılığın binde bir görüldüğü bir veri setinde "hiç yok" diyen model %99,9 doğruluk alır. Doğru metrik nasıl seçilir?
 Çılgın Yazılım
3 dk okuma
İçindekiler
Bu yazıyı dinle
Yapay zekâ sesiyle yaklaşık 2 dakikalık özet
Dengesiz veri seti, makine öğrenmesi projelerinde en sık karşılaşılan ve en sık yanlış değerlendirilen durumdur. Dolandırıcılık tespiti, hastalık taraması, makine arızası tahmini, spam filtreleme — hepsinde aradığınız şey nadirdir. Ve tam da bu nadirlik, en yaygın metriği kullanışsız hâle getirir.
Sorunun en net hâli
100.000 işlemden 100'ünün dolandırıcılık olduğu bir veri setiniz olsun. Hiçbir şey öğrenmeyen, her işleme "temiz" diyen bir model kurun. Bu modelin doğruluk oranı %99,9'dur. Metriğe bakan bir yönetici bunu mükemmel bir sonuç sanır; oysa model, çözmesi istenen problemin tamamını kaçırmıştır.
Bu uç örnek abartı gibi görünse de, gerçek projelerde daha sinsi bir biçimde ortaya çıkar: model azınlık sınıfını öğrenmek yerine çoğunluğa yaklaşmayı öğrenir, doğruluk yüksek çıkar ve sorun ancak üretimde fark edilir.
Karmaşıklık matrisi: her şeyin başladığı yer
Tek bir sayıya bakmadan önce dört sayıya bakmak gerekir: doğru pozitif (yakalanan dolandırıcılık), yanlış pozitif (temiz işleme yanlışlıkla dolandırıcılık demek), yanlış negatif (kaçırılan dolandırıcılık) ve doğru negatif. Modelin işe yarayıp yaramadığı bu dört sayının dağılımında görünür; tek bir özet metrik bu bilgiyi her zaman gizler.
Precision (kesinlik)
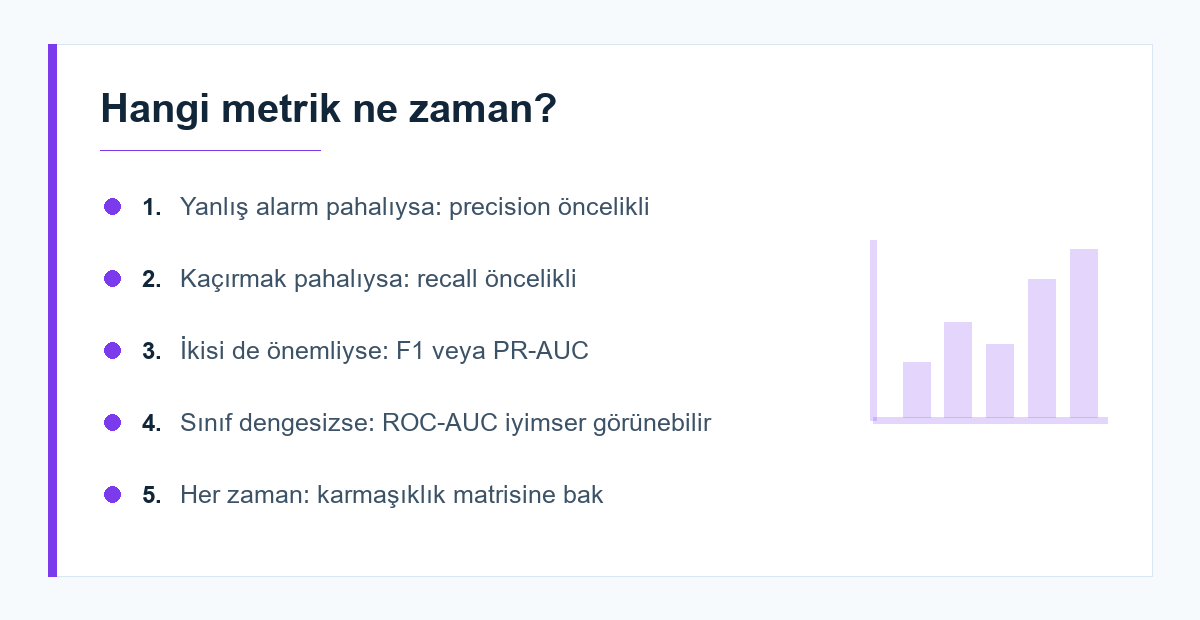
"Dolandırıcılık dediklerimin kaçı gerçekten dolandırıcılıktı?" Yanlış alarmın maliyeti yüksekse — örneğin her alarm bir müşteriyi rahatsız ediyorsa veya bir operatörün elle incelemesini gerektiriyorsa — öncelikli metrik budur.
Recall (duyarlılık)
"Gerçek dolandırıcılıkların kaçını yakaladım?" Kaçırmanın maliyeti yüksekse — hastalık taraması, kritik arıza tahmini — öncelik buradadır. Recall'ü artırmak neredeyse her zaman precision'ı düşürür; bu bir ödünleşimdir, çözülecek bir hata değil.
F1 ve PR-AUC
F1, precision ve recall'ün harmonik ortalamasıdır ve ikisi de önemliyken tek sayı isteyenler için kullanışlıdır. Dengesiz veri setlerinde ROC eğrisi altındaki alan (ROC-AUC) iyimser görünme eğilimindedir; çünkü doğru negatiflerin bolluğu eğriyi yukarı çeker. Bu durumlarda precision-recall eğrisi altındaki alan (PR-AUC) daha dürüst bir resim verir.
Metrik seçimi aslında bir iş kararıdır
Burada en çok atlanan nokta şudur: hangi metriği optimize edeceğiniz teknik bir tercih değil, iş tarafıyla birlikte verilmesi gereken bir karardır. "Bir dolandırıcılığı kaçırmanın ortalama maliyeti ne kadar? Bir yanlış alarmın maliyeti ne kadar?" sorularının cevabı, eşiği nereye koyacağınızı belirler. Bu sayılar bilinmiyorsa, modelden önce onları tahmin etmek gerekir — aksi hâlde model doğru çalışsa bile yanlış noktada çalışır. Bu tür kararların kurum içinde ortak bir dille alınabilmesi için veri odaklı karar kültürü yazımız ilgili bir okumadır.
Eşik ayarı: çoğu zaman en hızlı kazanç
Sınıflandırıcıların çoğu aslında olasılık üretir; 0,5 eşiği yalnızca bir varsayılandır ve dengesiz veride neredeyse her zaman yanlış yerdedir. Modeli hiç değiştirmeden eşiği kaydırmak, precision-recall dengesini iş ihtiyacına taşımanın en ucuz yoludur. Doğru pratik şudur: eşiği eğitim verisinde değil, ayrı bir doğrulama kümesinde seçin ve seçtiğiniz eşiği üretimde de aynı şekilde uygulayın.
Örnekleme ve sınıf ağırlıkları
Dengesizlikle başa çıkmanın üç yaygın yolu vardır:
- Sınıf ağırlığı: Modele azınlık sınıfındaki hataları daha pahalı say demek. Genellikle ilk denenmesi gereken, en az yan etkili yöntemdir.
- Aşağı örnekleme: Çoğunluk sınıfından örnek atmak. Hızlıdır ama veri kaybettirir.
- Yukarı örnekleme / sentetik üretim (SMOTE gibi): Azınlık sınıfını çoğaltmak. Etkili olabilir, ancak kritik bir kuralı vardır: örnekleme yalnızca eğitim kümesine uygulanır. Doğrulama ve test kümeleri gerçek dağılımı yansıtmalıdır.
Bu son kural, en sık yapılan metodolojik hatalardan birini önler: örneklemeyi bölme işleminden önce yapmak, sentetik örneklerin hem eğitimde hem testte görünmesine ve skorların gerçek dışı yükselmesine yol açar. Bu, bir tür veri sızıntısıdır; benzer tuzaklar için veri sızıntısı yazımıza bakmanızı öneririz.
Üretimde dağılım değişirse
Dengesiz veride bir başka incelik, sınıf oranının zamanla değişmesidir. Dolandırıcılık oranı kampanya dönemlerinde artabilir, spam oranı bir saldırı sırasında fırlayabilir. Eğitim sırasındaki orana göre ayarlanan eşik, oran değiştiğinde yanlış noktaya kayar. Bu yüzden yalnızca model performansını değil, girdi dağılımını da izlemek gerekir; konu hakkında veri kayması yazımız ayrıntılı bir çerçeve sunuyor. Metriklerin matematiksel tanımları ve uygulama örnekleri için scikit-learn model değerlendirme dokümantasyonu güvenilir bir referanstır.
Sonuç
Dengesiz veri setlerinde doğruluk oranı, modelin ne kadar iyi olduğunu değil, verinin ne kadar dengesiz olduğunu ölçer. Doğru yaklaşım tek bir metriğe bakmak yerine karmaşıklık matrisiyle başlamak, hangi hatanın daha pahalı olduğunu iş tarafıyla birlikte belirlemek, eşiği bu karara göre ayarlamak ve örneklemeyi yalnızca eğitim kümesine uygulamaktır. Bir sonraki model raporunuzda accuracy satırının yanına precision ve recall'ü de ekleyin; çoğu ekip bu üç sayıyı yan yana ilk kez gördüğünde modelin ne yaptığını da ilk kez anlar.
İlgili Yazılar
Sık sorulan sorular
Ne kadar dengesizlik "dengesiz" sayılır?
Kesin bir eşik yoktur, ancak azınlık sınıfı %10'un altına indiğinde accuracy hızla anlamsızlaşır; %1'in altında ise tamamen yanıltıcıdır.
SMOTE her zaman işe yarar mı?
Hayır. Yüksek boyutlu veride veya sınıflar iç içe geçmişse sentetik örnekler gürültü üretebilir. Sınıf ağırlığıyla başlamak genellikle daha güvenlidir.
ROC-AUC'yi hiç kullanmamalı mıyım?
Kullanabilirsiniz, ancak dengesiz veride tek başına raporlamayın. PR-AUC ile birlikte bakmak, modelin azınlık sınıfındaki gerçek performansını görmenizi sağlar.
Eşiği nasıl seçmeliyim?
İş maliyetlerini biliyorsanız beklenen maliyeti minimize eden noktayı seçin. Bilmiyorsanız precision-recall eğrisinde işletmenin kabul edebileceği yanlış alarm oranına karşılık gelen noktayı belirleyin.
Yazan
Çılgın Yazılım
Ben Evren Çılgın; yazılım geliştirme, web teknolojileri ve sistem tasarımı alanlarında uzmanlaşmış bir geliştiriciyim. Uzun yıllardır hem frontend hem de backend tarafında üretken, ölçeklenebilir ve kullanıcı dostu çözümler üretiyorum.
Bu konuda bir projeniz mi var?
İhtiyacınızı birkaç cümleyle anlatın; uygun yaklaşımı birlikte belirleyelim.
İlgili yazılar


Yorumlar
Henüz yorum yok. Sorunuzu ya da deneyiminizi ilk siz yazın.
Yorum yazın
Yorumunuz onaylandıktan sonra yayınlanır. Ekibimiz gerekirse konuyla ilgili bir yanıt da paylaşır.