
LLM Maliyetini Kaliteden Ödün Vermeden Düşürmenin 7 Yolu
Fatura beklenenin üç katı çıktıysa sorun genelde model seçiminde değil, gereksiz gönderilen bağlamdadır.
 Çılgın Yazılım
4 dk okuma
İçindekiler
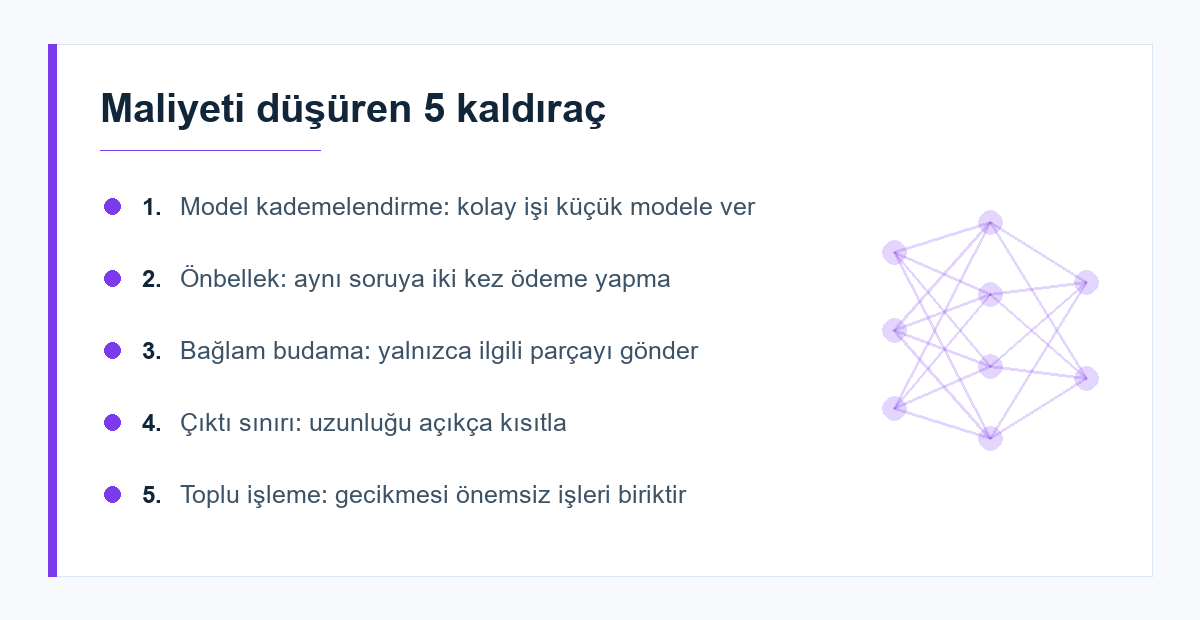
- 1. Model kademelendirme: her işe aynı modeli göndermeyin
- 2. Önbellekleme: aynı soruya iki kez ödemeyin
- 3. Bağlam budama: en büyük israf kalemi
- 4. Çıktı uzunluğunu açıkça sınırlayın
- 5. Toplu işleme ve asenkron kuyruk
- 6. İstem uzunluğunu ölçün, tahmin etmeyin
- 7. Modeli her yerde kullanmayın
- Kaliteyi korumak: değerlendirme olmadan optimizasyon olmaz
- Sonuç
- İlgili Yazılar
Bu yazıyı dinle
Yapay zekâ sesiyle yaklaşık 2 dakikalık özet
LLM maliyeti, yapay zekâ özelliği ekleyen ekiplerin en sık sürpriz yaşadığı kalemdir. Geliştirme sırasında birkaç dolar olan fatura, özellik yayına çıktıktan sonra beklenenin çok üzerine çıkar. İlk refleks genellikle daha ucuz bir modele geçmek olur; oysa kazancın büyük kısmı model değiştirmeden, ne gönderdiğinizi ve ne sıklıkla gönderdiğinizi düzenleyerek elde edilir. İşte sahada en çok işe yarayan yedi yöntem.
1. Model kademelendirme: her işe aynı modeli göndermeyin
Uygulamanızdaki isteklerin hepsi aynı zorlukta değildir. Bir metni kategorilere ayırmak, bir cümleyi düzeltmek veya bir listeyi biçimlendirmek küçük modellerin rahatlıkla yaptığı işlerdir. Buna karşılık çok adımlı akıl yürütme, karmaşık kod üretimi veya uzun belge analizi büyük model gerektirir.
Pratik kurgu şudur: istekleri önce ucuz modele gönderin, sonucun güven skorunu veya bir doğrulama kontrolünü kullanarak gerekiyorsa büyük modele yükseltin. Uygulamalarda isteklerin çoğunluğunun basit sınıfa girdiği görülür; bu dağılım tek başına faturayı belirgin şekilde düşürür.
2. Önbellekleme: aynı soruya iki kez ödemeyin
Kullanıcıların sorduğu sorular sanıldığından çok daha fazla tekrar eder. Normalize edilmiş istem metninin karmasını (hash) anahtar olarak kullanan basit bir önbellek, tekrar eden isteklerde hem maliyeti hem gecikmeyi sıfıra indirir. Önbelleğe alırken dikkat edilmesi gerekenler: kullanıcıya özel veri içeren istemleri kullanıcı kimliğiyle birlikte anahtarlamak, ve yanıtın tazeliğinin önemli olduğu durumlarda makul bir yaşam süresi tanımlamak.
Ayrıca birçok sağlayıcı, istemin sabit kalan başlangıç kısmı için istem önbelleği sunar. Uzun bir sistem talimatınız veya sabit bir doküman bağlamınız varsa, bu bölümü istemin başında ve değişmez tutmak ciddi tasarruf sağlar — değişken kısımları sona koymak tek başına önemli bir optimizasyondur.
3. Bağlam budama: en büyük israf kalemi
Maliyetin çoğu genellikle çıktıda değil, girdide birikir. Belge tabanlı soru cevaplama (RAG) kurgularında ekipler güvenli tarafta kalmak için ilk 20 parçayı gönderir; oysa çoğu soru için 3-5 parça yeterlidir ve fazlası doğruluğu artırmadığı gibi bazen azaltır. Yapılması gerekenler:
- Getirilen parça sayısını deneyerek kalibre edin; doğruluk eğrisi genellikle erken düzleşir.
- Yeniden sıralama (reranking) kullanarak az sayıda ama isabetli parça gönderin.
- Sohbet geçmişini sınırsız taşımayın; eski turları özetleyerek sıkıştırın.
- Gönderilen belgelerden gereksiz biçimlendirme, tekrar eden başlık ve gezinme metinlerini temizleyin.
Doğruluğu korurken bağlamı kısmanın yöntemleri, halüsinasyonu azaltma çalışmalarıyla doğrudan örtüşür; bu konuda halüsinasyon azaltma yazımız tamamlayıcıdır.
4. Çıktı uzunluğunu açıkça sınırlayın
Çıktı tokenları genellikle girdiden birkaç kat pahalıdır. Modele "kısa cevap ver" demek yeterli değildir; hem max_tokens sınırı koymak hem de istenen biçimi kesin tanımlamak gerekir. "En fazla üç madde, her madde en fazla 15 kelime" gibi bir talimat, hem maliyeti hem de arayüzdeki tutarlılığı iyileştirir. Yapılandırılmış çıktı (JSON şeması) kullanmak, modelin gereksiz açıklama üretmesini de engeller.
5. Toplu işleme ve asenkron kuyruk
Her isteğin anında yanıtlanması gerekmez. Gecelik özet üretimi, toplu etiketleme veya arşiv analizi gibi işler için sağlayıcıların toplu (batch) uçları genellikle belirgin indirim sunar. Bunun için işleri bir kuyruğa alıp gecikmeye duyarlı olmayanları ayırmak gerekir — bu ayrım, mimari olarak da sağlıklıdır çünkü kullanıcıyı yavaş bir modele bağlı bekletmez.
6. İstem uzunluğunu ölçün, tahmin etmeyin
Ekiplerin çoğu istem uzunluğunu hiç ölçmez. Oysa istek başına gönderilen token sayısını kaydetmek, en pahalı kod yolunu bulmanın en hızlı yoludur. Genellikle tek bir özellik — örneğin her istekte tüm ürün kataloğunu bağlama ekleyen bir yardımcı — faturanın büyük kısmını tek başına üretir. İstek başına token, model ve maliyet bilgisini log'lamak, bu yazıdaki diğer altı yöntemin nereye uygulanacağını da söyler.
7. Modeli her yerde kullanmayın
En etkili maliyet optimizasyonu bazen LLM'i devreden çıkarmaktır. Sabit kurallarla çözülebilecek bir sınıflandırma, düzenli ifadeyle yapılabilecek bir ayrıştırma veya arama indeksiyle cevaplanabilecek bir sorgu için dil modeli çağırmak hem pahalı hem yavaş hem de daha hatalıdır. Kurulacak doğru zihin modeli şudur: LLM, belirsizliği yüksek ve dile dayalı işler için bir araçtır; deterministik işler için değil.
Entegrasyonun genel mimarisi ve üretim hazırlığı için LLM entegrasyonu yazımıza bakabilirsiniz. Sağlayıcı tarafındaki maliyet ve önbellekleme ayrıntıları hızlı değiştiği için, güncel bilgiyi resmî istem önbellekleme dokümantasyonundan takip etmek gerekir.
Kaliteyi korumak: değerlendirme olmadan optimizasyon olmaz
Bu yöntemlerin hepsi kaliteyi düşürme riski taşır. Bu yüzden optimizasyona başlamadan önce küçük ama gerçek bir değerlendirme kümesi oluşturmak gerekir: uygulamanızdan alınmış 50-100 gerçek girdi ve bunlar için kabul edilebilir cevaplar. Her optimizasyon adımından sonra bu kümeyi çalıştırıp doğruluk düşüşünü ölçün. Değerlendirme kümesi olmadan yapılan maliyet optimizasyonu, farkında olmadan ürünü bozmaktır. Modelin zamanla sessizce bozulması ayrı bir risktir; bu konuda veri kayması yazımıza bakabilirsiniz.
Sonuç
LLM maliyeti, model fiyat listesinden çok mimari kararlarla belirlenir: hangi işe hangi modeli gönderdiğiniz, ne kadar bağlam taşıdığınız, tekrar eden isteklere ne yaptığınız ve gerçekten model gerektiren işleri ayırt edip etmediğiniz. Bu yedi kaldıracın hepsini birden uygulamanız gerekmez; çoğu ekipte istek başına token ölçümü ve bağlam budaması tek başına faturanın önemli bir kısmını geri kazandırır. Bugün atılacak ilk adım basit: son 1.000 isteğinizin ortalama girdi token sayısını hesaplayın. Bu tek sayı, nereye müdahale edeceğinizi genellikle doğrudan gösterir.
İlgili Yazılar
Sık sorulan sorular
Daha ucuz bir modele geçmek en kolay çözüm değil mi?
Bazen öyledir, ancak kalite düşüşü ölçülmeden yapılan geçiş kullanıcı memnuniyetine zarar verir. Model kademelendirme, kolay işleri ucuz modele yönlendirip zor işleri güçlü modelde bırakarak bu ödünleşimi ortadan kaldırır.
Önbellekleme yanlış cevap döndürme riski taşır mı?
Yanıtın zamana veya kullanıcıya bağlı olduğu durumlarda evet. Bu yüzden önbellek anahtarına kullanıcı ve veri sürümü bilgisi eklemek, ayrıca makul bir geçerlilik süresi tanımlamak gerekir.
RAG kurgusunda kaç parça göndermeliyim?
Sabit bir doğru sayı yoktur; kendi değerlendirme kümenizde parça sayısını artırarak doğruluğun nerede düzleştiğini ölçün. Çoğu uygulamada bu nokta beklenenden erken gelir.
Streaming yanıt maliyeti etkiler mi?
Toplam token sayısını değiştirmez, dolayısıyla maliyeti doğrudan düşürmez. Ancak algılanan gecikmeyi azalttığı için kullanıcı deneyimini iyileştirir ve daha kısa çıktıların kabul edilebilir olmasını kolaylaştırır.
Yazan
Çılgın Yazılım
Ben Evren Çılgın; yazılım geliştirme, web teknolojileri ve sistem tasarımı alanlarında uzmanlaşmış bir geliştiriciyim. Uzun yıllardır hem frontend hem de backend tarafında üretken, ölçeklenebilir ve kullanıcı dostu çözümler üretiyorum.
Bu konuda bir projeniz mi var?
İhtiyacınızı birkaç cümleyle anlatın; uygun yaklaşımı birlikte belirleyelim.
İlgili yazılar

Yorumlar
Henüz yorum yok. Sorunuzu ya da deneyiminizi ilk siz yazın.
Yorum yazın
Yorumunuz onaylandıktan sonra yayınlanır. Ekibimiz gerekirse konuyla ilgili bir yanıt da paylaşır.