
Veritabanı ve Performans kod örnekli
N+1 Sorgu Problemi: Fark Etmesi Zor, Etkisi Büyük
20 kayıtla hızlı çalışan sayfa, 2.000 kayıtla neden çöküyor? En yaygın ORM performans tuzağı ve çözümü.
 Çılgın Yazılım
3 dk okuma
İçindekiler
Bu yazıyı dinle
Yapay zekâ sesiyle yaklaşık 2 dakikalık özet
N+1 sorgu problemi, web uygulamalarındaki yavaşlıkların en yaygın ve en sinsi sebebidir. Sinsidir çünkü geliştirme ortamında hiç fark edilmez: yerel veritabanınızda 20 kayıt vardır, sayfa 80 milisaniyede açılır, her şey yolunda görünür. Üretimde aynı sayfa 2.000 kayıtla açıldığında ise saniyeler sürer ve kimse tek bir "yavaş sorgu" bulamaz — çünkü sorguların hiçbiri tek başına yavaş değildir. Sorun, sayılarındadır.
Problem tam olarak nasıl oluşur?
Bir sipariş listesi gösterdiğinizi düşünün ve her siparişin yanında müşteri adı yazsın. Kod tipik olarak şöyledir:
$siparisler = $siparisModel->findAll();          // 1 sorgu

foreach ($siparisler as $siparis) {
    // Her döngüde BİR sorgu daha çalışır
    $musteri = $musteriModel->find($siparis['musteri_id']);
    echo $musteri['ad'];
}
Burada 1 sorgu listeyi getirir, ardından N kayıt için N sorgu daha çalışır — toplam N+1. Yüz siparişte 101 sorgu, iki bin siparişte 2.001 sorgu demektir. Her sorgu tek başına belki 0,4 milisaniyedir; ama her birinin ağ gidiş-dönüşü, bağlantı yükü ve sonuç dönüştürme maliyeti vardır. İki bin kez ödenen küçük bir maliyet, büyük bir maliyettir.
Kod bu kadar açık yazıldığında fark edilir. Asıl tehlike, ilişkinin görünümde (view) veya bir yardımcı metotta gizlendiği durumlardır: şablonda $siparis->musteri->ad yazmak, arkada sessizce bir sorgu çalıştırır ve kod incelemesinde kimsenin gözüne çarpmaz.
Nasıl tespit edilir?
Tahmin etmeye gerek yok; ölçmek kolaydır.
- Sorgu sayacı: Geliştirme ortamında her istek sonunda çalışan sorgu sayısını ve toplam süreyi yazdırın. CodeIgniter'da hata ayıklama araç çubuğu, diğer çerçevelerde benzer paneller bunu hazır sunar. Bir liste sayfasında 200 sorgu görüyorsanız teşhis konmuş demektir.
- Yavaş sorgu günlüğü yetmez: N+1'de tek tek sorgular hızlıdır, bu yüzden yavaş sorgu günlüğüne düşmezler. Aramanız gereken şey süre değil, adettir.
- APM ve izleme: İstek başına sorgu sayısını izleyen bir performans izleme katmanı, sorunu üretimde ortaya çıkmadan önce yakalar. Aynı uca gelen isteklerde sorgu sayısı kayıt sayısıyla birlikte artıyorsa, elinizde N+1 var demektir.
- Tekrarlanan sorguyu arayın: Sorgu günlüğünde yalnızca parametresi değişen, yapısı aynı yüzlerce satır görüyorsanız kaynak bulunmuştur.
Çözüm 1: İlişkiyi önceden yükle
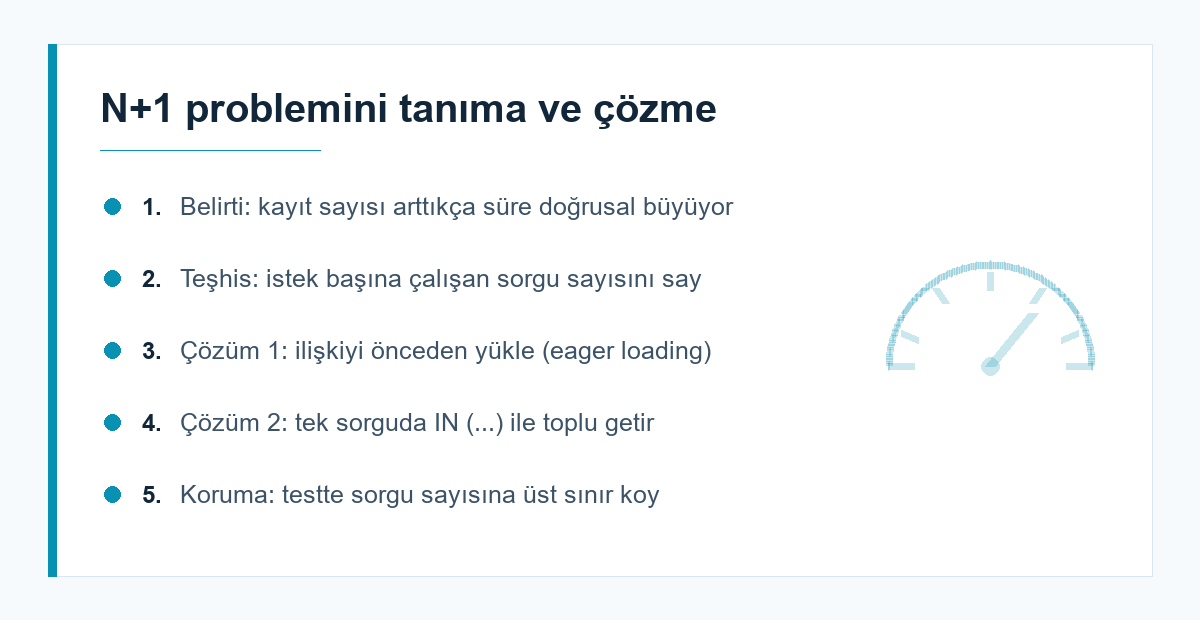
Temel fikir, N sorgu yerine 2 sorgu çalıştırmaktır: önce siparişleri getir, sonra ihtiyaç duyulan tüm müşteri kimliklerini tek seferde topla.
$siparisler = $siparisModel->findAll();

$musteriIdler = array_unique(array_column($siparisler, 'musteri_id'));
$musteriler   = $musteriModel->whereIn('id', $musteriIdler)->findAll();

// Kimliğe göre indeksle, döngüde hafızadan oku
$musteriHaritasi = array_column($musteriler, null, 'id');

foreach ($siparisler as $siparis) {
    echo $musteriHaritasi[$siparis['musteri_id']]['ad'] ?? '-';
}
Toplam sorgu sayısı, kayıt adedinden bağımsız olarak 2'ye iner. Bu, ORM'lerin "eager loading" veya "with" olarak adlandırdığı özelliğin elle yazılmış hâlidir.
Çözüm 2: Tek sorguda birleştirme
İlişkili veriden yalnızca birkaç alan gerekiyorsa, JOIN ile tek sorguya indirmek daha da verimlidir. Ancak dikkat: bire-çok ilişkilerde JOIN satır sayısını çarpar ve büyük veri kümelerinde iki ayrı sorgudan daha pahalı hâle gelebilir. Genel kural, bire-bir ve çoka-bir ilişkilerde JOIN'in, bire-çok ilişkilerde ayrı toplu sorgunun tercih edilmesidir.
Her iki durumda da sorgunun gerçekten indeksten faydalandığından emin olmak gerekir; whereIn ile gönderilen listenin karşılık geldiği sütunda indeks yoksa kazanç kaybolur. Sorgu planını okumak için EXPLAIN rehberimize bakabilirsiniz.
Çözüm 3: Fazla veriyi hiç getirmemek
Bazen doğru çözüm sorguyu optimize etmek değil, ihtiyaç olmayan veriyi hiç istememektir. Sayfalama eklemek, listede yalnızca gösterilen alanları seçmek ve ilişkiyi ancak gerçekten gösteriliyorsa yüklemek, sorunu kökten kaldırır. Aşırı yüklenen bir liste sayfasında en büyük kazanç genellikle buradan gelir.
Tekrar oluşmasını nasıl önlersiniz?
N+1 düzeltilir, birkaç ay sonra başka bir yerde geri gelir. Kalıcı koruma için iki pratik işe yarar:
- Testte sorgu sayısına üst sınır koyun. Kritik uçlar için "bu istek en fazla 10 sorgu çalıştırmalı" biçiminde bir iddia yazmak, regresyonu birleştirme öncesinde yakalar. Bu, test yazarken en çok geri dönen yatırımlardan biridir; test stratejisinin genel çerçevesi için test rehberimize bakın.
- Sorgu sayısını izleyin. Üretimde istek başına ortalama sorgu sayısını bir gösterge olarak takip edin. Bu sayının sessizce artması, kod tabanında yeni bir N+1 doğduğunun en erken sinyalidir.
Yanıt sürelerini kod değiştirmeden iyileştirmenin tamamlayıcı yöntemleri için API hızlandırma yazımız, ölçüm önceliğinin genel mantığı için ölçerek başlama yazımız ilgili okumalardır. Performans bütçesi kavramı için web.dev performans bütçeleri rehberi faydalıdır.
Sonuç
N+1 sorgu problemi, kötü yazılmış bir sorgudan değil, doğru yazılmış çok sayıda sorgudan kaynaklanır — bu yüzden klasik performans araçlarının çoğunda görünmez. Tespitin anahtarı süreyi değil adedi ölçmektir; çözümün anahtarı ise ilişkili veriyi döngü içinde değil, döngüden önce toplu olarak getirmektir. Bugün uygulamanızın en kalabalık liste sayfasını açıp çalışan sorgu sayısına bakın. Sayı, ekrandaki satır sayısına yakınsa, muhtemelen en büyük performans kazancınızı bulmuşsunuzdur.
Sık sorulan sorular
N+1 problemi sadece ORM kullanınca mı olur?
Hayır, elle yazılmış SQL'de de döngü içinde sorgu çalıştırıldığında aynı sorun oluşur. ORM'ler ilişkiyi gizlediği için sorunu görünmez kıldıklarından daha sık rastlanır.
Her zaman eager loading kullanmalı mıyım?
Hayır. İlişkili veri gerçekten kullanılmıyorsa önceden yüklemek gereksiz yük getirir. Kural, döngü içinde erişilen ilişkileri önceden yüklemek, erişilmeyenleri bırakmaktır.
JOIN mi, iki ayrı sorgu mu daha hızlı?
Çoka-bir ilişkilerde JOIN genellikle daha iyidir. Bire-çok ilişkilerde JOIN satırları çarpacağı için iki ayrı sorgu ve hafızada eşleştirme çoğu zaman daha verimlidir.
Önbellekleme N+1 problemini çözer mi?
Belirtiyi hafifletir, sebebi ortadan kaldırmaz. Önbellek boşaldığında veya yeni verilerde sorun aynen geri döner; ayrıca gereksiz karmaşıklık ekler.
Yazan
Çılgın Yazılım
Ben Evren Çılgın; yazılım geliştirme, web teknolojileri ve sistem tasarımı alanlarında uzmanlaşmış bir geliştiriciyim. Uzun yıllardır hem frontend hem de backend tarafında üretken, ölçeklenebilir ve kullanıcı dostu çözümler üretiyorum.
Bu konuda bir projeniz mi var?
İhtiyacınızı birkaç cümleyle anlatın; uygun yaklaşımı birlikte belirleyelim.
İlgili yazılar


Yorumlar
Henüz yorum yok. Sorunuzu ya da deneyiminizi ilk siz yazın.
Yorum yazın
Yorumunuz onaylandıktan sonra yayınlanır. Ekibimiz gerekirse konuyla ilgili bir yanıt da paylaşır.