
Veritabanı ve Performans kod örnekli
Veritabanı Sorgusunu Değil Erişim Desenini Düzeltmek: Toplu Yükleme
İndeks eklemek her zaman çözüm değildir. Bazen sorun tek sorgunun yavaşlığı değil, çok fazla sorgu atmanızdır.
 Çılgın Yazılım
5 dk okuma

İçindekiler
Bu yazıyı dinle
Yapay zekâ sesiyle yaklaşık 2 dakikalık özet
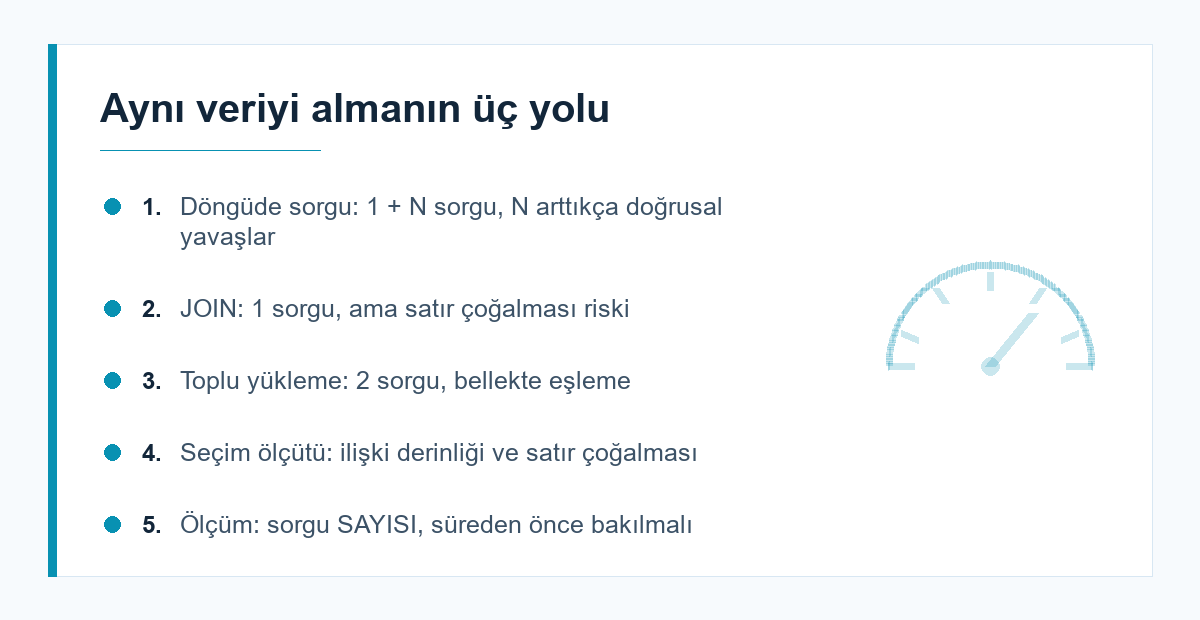
Toplu yükleme, bir listedeki her kayıt için ayrı sorgu atmak yerine, ihtiyaç duyulan tüm kimlikleri toplayıp tek sorguda çekmek ve sonucu bellekte eşlemektir. Performans çalışmalarında en çok kazanç veren müdahalelerden biridir, çünkü sorunun kaynağı çoğu zaman sorgunun yavaşlığı değil, sorgu sayısıdır.
Belirti: her şey hızlı ama sayfa yavaş
Yavaş sorgu günlüğü boş, indeksler yerinde, her sorgu 0,8 milisaniye. Buna rağmen sayfa 2,4 saniyede açılıyor. Sebep genellikle şudur: sayfa 300 sorgu atıyor ve her biri ayrı bir gidiş-dönüş (round trip) maliyeti taşıyor.
// Sorunlu desen: döngü içinde sorgu (N+1)
$siparisler = $siparisModel->findAll(100);           // 1 sorgu

foreach ($siparisler as &$s) {
    $s['musteri'] = $musteriModel->find($s['musteri_id']);   // +100 sorgu
    $s['kalemler'] = $kalemModel->where('siparis_id', $s['id'])->findAll();  // +100 sorgu
}
Toplam 201 sorgu. Yerel makinede fark edilmez; veritabanı ayrı bir sunucudaysa her sorgu 1 milisaniye ağ gecikmesi eklese bile 200 milisaniye kaybedersiniz. Bu problemin tespiti için N+1 sorgu problemini nasıl tespit edersiniz yazımızdaki yöntemler doğrudan uygulanabilir.
Çözüm: topla, tek sorguda çek, eşle
$siparisler = $siparisModel->findAll(100);                       // 1. sorgu

// 1) Gerekli kimlikleri topla
$musteriIdler = array_values(array_unique(array_filter(array_column($siparisler, 'musteri_id'))));
$siparisIdler = array_column($siparisler, 'id');

// 2) Tek sorguda çek
$musteriler = $musteriIdler
    ? array_column($musteriModel->whereIn('id', $musteriIdler)->findAll(), null, 'id')
    : [];                                                        // 2. sorgu

// 3) Kalemleri sipariş kimliğine göre grupla
$kalemler = [];
foreach ($kalemModel->whereIn('siparis_id', $siparisIdler)->findAll() as $k) {  // 3. sorgu
    $kalemler[$k['siparis_id']][] = $k;
}

// 4) Bellekte eşle — bu adım sorgu maliyeti taşımaz
foreach ($siparisler as &$s) {
    $s['musteri']  = $musteriler[$s['musteri_id']] ?? null;
    $s['kalemler'] = $kalemler[$s['id']] ?? [];
}
unset($s);
201 sorgu 3'e indi. Daha önemlisi: kayıt sayısı 100'den 1000'e çıkarsa sorgu sayısı hâlâ 3 kalır. Sabit sorgu sayısı, ölçeklenebilirliğin en pratik göstergesidir.
Neden her zaman JOIN değil?
JOIN doğru araçtır — ta ki bire-çok ilişkilerde satır çoğalması başlayana kadar. 100 sipariş ve sipariş başına 8 kalem, JOIN ile 800 satır döndürür ve sipariş alanları 8 kez tekrarlanır. Bu, ağdan taşınan veri miktarını ve PHP tarafındaki gruplama işini artırır.
Pratik kural: bire-bir ilişkilerde JOIN, bire-çok ilişkilerde toplu yükleme. İkiden fazla bire-çok ilişkiyi tek JOIN'de birleştirmek ise neredeyse her zaman hatadır (kartezyen çarpım).
IN listesinin sınırı
Binlerce kimlikle WHERE IN kullanmak sorgu boyutunu şişirir ve bazı sürücülerde parametre sınırına takılır. Çözüm parçalara bölmektir:
function toplulaGetir(array $idler, callable $sorgu, int $parcaBoyutu = 500): array
{
    $sonuc = [];
    foreach (array_chunk($idler, $parcaBoyutu) as $parca) {
        foreach ($sorgu($parca) as $satir) {
            $sonuc[] = $satir;
        }
    }

    return $sonuc;
}

$musteriler = toplulaGetir(
    $musteriIdler,
    static fn(array $parca) => (new MusteriModel())->whereIn('id', $parca)->findAll()
);
Aynı yaklaşım kuyruğa alınan işlerde de geçerlidir; uzun ömürlü işçilerin nasıl yönetileceğini systemd servisi yazma rehberimizde ele aldık.
Ölçüm alışkanlığı model değerlendirmesinde de aynıdır; çapraz doğrulamada zaman sızıntısı yazımız bunun veri tarafındaki karşılığı.
Ölçmeden "iyileştirdim" demeyin
Süreyi değil, önce sorgu sayısını ölçün. Sayı sabitlendiğinde süre zaten düşer; süre düşse bile sayı hâlâ N ile artıyorsa sorun ertelenmiş demektir.
$db = db_connect();
$oncesi = count($db->getQueries());

$veri = $servis->listeyiHazirla();

log_message('debug', 'Sorgu sayısı: ' . (count($db->getQueries()) - $oncesi));
İndeks tarafında yapılacak bir şey kalmadığını doğrulamak içinse EXPLAIN çıktısını okuma yazımız iyi bir kontrol listesidir. Sorgu planlarının resmî anlatımı için MySQL EXPLAIN belgeleri başvuru kaynağıdır.
Sonuç
Performans çalışmasında ilk soru "hangi sorgu yavaş?" değil, "kaç sorgu atıyoruz?" olmalıdır. Toplu yükleme deseni bu sayıyı kayıt adedinden bağımsız hâle getirir: kimlikleri topla, tek sorguda çek, bellekte eşle. Bire-bir ilişkilerde JOIN'i tercih edin, bire-çok ilişkilerde toplu yüklemeye geçin, IN listelerini parçalara bölün ve her değişiklikten sonra sorgu sayısını yeniden ölçün. Bir sonraki yavaş sayfada profil aracını açmadan önce sorgu sayacına bakın — cevap çoğu zaman orada duruyordur.
Pratik Uygulama Kontrol Listesi
Bu yazıdaki önerileri kendi ekibinize uyarlarken aşağıdaki adımları sırasıyla uygulamanız, teoriden pratiğe geçişi kolaylaştırır:
- Mevcut durumu ölçün. Değişiklik yapmadan önce bugünkü performansı/süreyi/hata oranını kaydedin; aksi halde iyileşmeyi kanıtlayamazsınız.
- Küçük bir pilot seçin. Tüm sisteme veya tüm ekibe birden uygulamak yerine tek bir modülde veya tek bir sprintte deneyin.
- Sonuçları ekiple paylaşın. Elde ettiğiniz veriyi (olumlu ya da olumsuz) kısa bir notla ekibe aktarın; kararın gerekçesi belgelenmemişse aynı tartışma birkaç ay sonra tekrar açılır.
- Süreci tekrarlanabilir hale getirin. İşe yarayan pratiği bir kontrol listesine veya şablona dönüştürün ki yeni katılan ekip üyeleri de aynı standardı hızlıca öğrensin.
Toplu Yükleme konusunda attığınız her küçük adım ölçülebilir olduğu sürece değerlidir; büyük ve tek seferlik dönüşümler yerine sürekli, küçük iyileştirmeler uzun vadede daha kalıcı sonuç verir.
Sık Yapılan Yanlışlar
Bu konuda ekiplerin en çok düştüğü tuzak, çözümü tek bir kişiye ya da tek bir araca yüklemektir. Oysa kalıcı iyileşme, sürecin ekibin günlük rutinine (code review kontrol listesi, sprint planlama, onboarding dokümanı gibi) gömülmesiyle mümkün olur. İkinci yaygın hata ise "en iyi pratiği" olduğu gibi kopyalamaktır — başka bir ekipte işe yarayan bir yaklaşım, farklı bir ölçekte veya farklı bir teknoloji yığınında aynı sonucu vermeyebilir; önce kendi bağlamınızda küçük ölçekte test edin, sonra genişletin. Üçüncü tuzak ise ölçmeden karar vermektir: "daha iyi hissettiriyor" öznel bir gerekçedir, ekip içi tartışmalarda nesnel veriyle desteklenmeyen kararlar er ya da geç sorgulanır ve geri alınır. Son olarak, dokümantasyonu atlamak da sık görülen bir hatadır: bir kararın "neden" alındığı yazılı değilse, ekip altı ay sonra aynı tartışmayı sıfırdan yeniden yapmak zorunda kalır ve önceki deneyimden öğrenilenler kaybolur.
Sonuç
Veritabanı Sorgusunu Değil Erişim Desenini Düzeltmek: Toplu Yükleme konusunda burada değindiğimiz noktalar, konuyu ilk kez ele alan ekipler için de deneyimli geliştiriciler için de pratik bir kontrol listesi görevi görür. toplu yükleme üzerine çalışırken en çok fayda sağlayan yaklaşım, tek seferde her şeyi mükemmelleştirmeye çalışmak yerine küçük, ölçülebilir adımlarla ilerlemektir. Ekibinizde bu konuyu bir sonraki sprint retrospektifinde veya teknik tartışma toplantısında gündeme getirmenizi, burada anlatılan pratiklerden hangilerinin sizin bağlamınıza uyduğunu birlikte değerlendirmenizi öneririz. Sonuç olarak, doğru araçları seçmek kadar bunları ekip kültürüne oturtmak da başarıyı belirleyen asıl etkendir.
Sık sorulan sorular
ORM kullanıyorum, eager loading zaten bunu yapmıyor mu?
Yapar; eager loading çoğu ORM'de tam olarak toplu yükleme desenini uygular. Ancak varsayılan olarak kapalıdır ve ilişkiyi döngü içinde çağırdığınızda sessizce lazy loading'e düşer. Desenin nasıl çalıştığını bilmek, ORM'in ne zaman devreye girmediğini fark etmenizi sağlar.
Toplu yükleme bellek tüketimini artırmaz mı?
Artırır, çünkü ilgili tüm kayıtlar aynı anda bellekte tutulur. Sayfalama yaptığınız sürece bu miktar sınırlıdır. Sayfalamasız binlerce kayıt işliyorsanız zaten farklı bir yaklaşım — akış (streaming) veya kuyruğa alınmış toplu iş — gerekir.
Kaç sorgu "çok" sayılır?
Mutlak bir sayı yerine davranışa bakın: kayıt sayısı iki katına çıktığında sorgu sayısı da iki katına çıkıyorsa sorun vardır. Sabit kalıyorsa 12 sorgu da kabul edilebilir, 3 sorgu da.
Bu deseni API yanıtlarında da kullanabilir miyim?
Evet ve orada özellikle değerlidir. Liste uçlarında ilişkili verileri toplu yüklemek, yanıt süresini kayıt sayısından bağımsız kılar; ayrıca istemcinin ek istek atmasını gerektirmediği için toplam gidiş-dönüş sayısını da düşürür.
Yazan
Çılgın Yazılım
Ben Evren Çılgın; yazılım geliştirme, web teknolojileri ve sistem tasarımı alanlarında uzmanlaşmış bir geliştiriciyim. Uzun yıllardır hem frontend hem de backend tarafında üretken, ölçeklenebilir ve kullanıcı dostu çözümler üretiyorum.
Bu konuda bir projeniz mi var?
İhtiyacınızı birkaç cümleyle anlatın; uygun yaklaşımı birlikte belirleyelim.
İlgili yazılar

Yorumlar
Henüz yorum yok. Sorunuzu ya da deneyiminizi ilk siz yazın.
Yorum yazın
Yorumunuz onaylandıktan sonra yayınlanır. Ekibimiz gerekirse konuyla ilgili bir yanıt da paylaşır.