
Yapay Zekâ ve Veri kod örnekli
LLM Çıktısını Şemaya Zorlamak: Serbest Metinden Güvenilir JSON’a
Model bazen JSON döndürür, bazen açıklama ekler. Üretimde ihtiyacınız olan şey umut değil, şema doğrulaması ve onarım döngüsü.
 Çılgın Yazılım
4 dk okuma

İçindekiler
Bir dil modelinden yapılandırılmış veri istediğinizde çoğu zaman istediğinizi alırsınız. Sorun "çoğu zaman" kelimesindedir. Üretimde çalışan bir sistemde llm çıktısı bazen kod bloğuyla sarılı gelir, bazen başına "Elbette, işte istediğiniz JSON:" cümlesi eklenir, bazen de tek bir alan eksik döner. Bu üç durumu tek tek ele almak yerine tek bir savunma hattı kurmak gerekir.
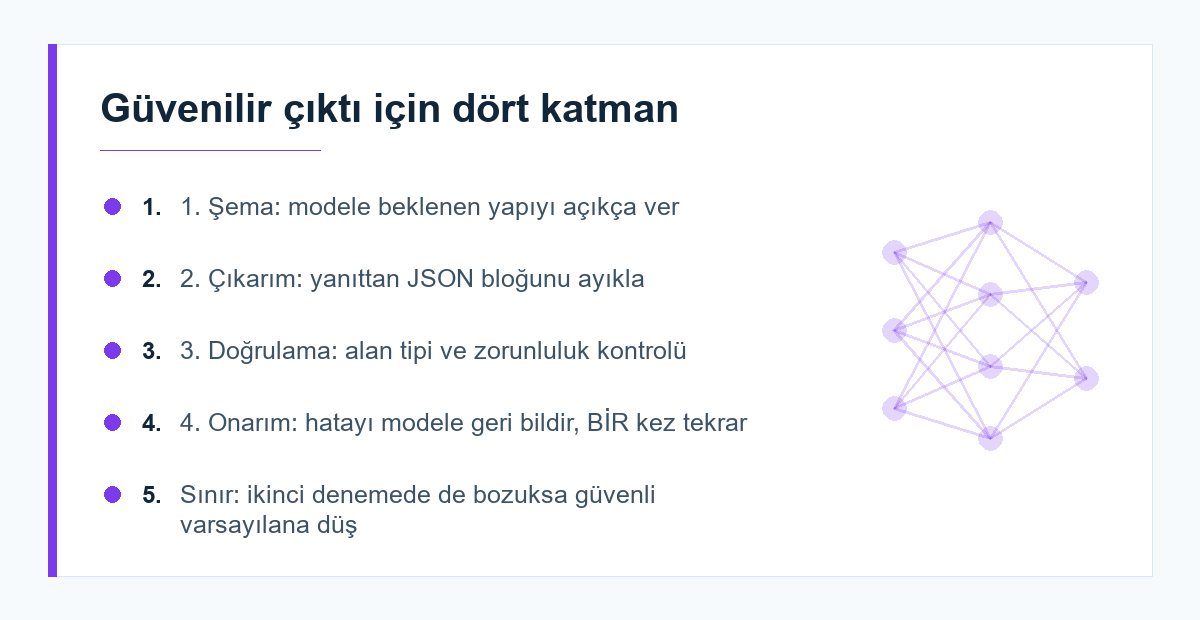
Katman 1: şemayı isteğin parçası yapın
Modele "JSON döndür" demek yeterli değildir. Alan adlarını, tiplerini ve izin verilen değerleri açıkça yazmak, hata oranını belirgin biçimde düşürür.
const SEMA = [
    'baslik'     => ['tip' => 'string', 'zorunlu' => true,  'maks' => 120],
    'ozet'       => ['tip' => 'string', 'zorunlu' => true,  'maks' => 300],
    'duygu'      => ['tip' => 'enum',   'zorunlu' => true,  'degerler' => ['olumlu', 'notr', 'olumsuz']],
    'etiketler'  => ['tip' => 'array',  'zorunlu' => false, 'maks' => 8],
];

function semaMetni(array $sema): string
{
    $satirlar = [];
    foreach ($sema as $alan => $k) {
        $ek = $k['tip'] === 'enum' ? ' (yalnızca: ' . implode(', ', $k['degerler']) . ')' : '';
        $satirlar[] = "- {$alan}: {$k['tip']}" . ($k['zorunlu'] ? ' [zorunlu]' : ' [isteğe bağlı]') . $ek;
    }

    return "Yanıtı SADECE geçerli JSON olarak ver. Açıklama, kod bloğu işareti veya "
        . "ek metin ekleme. Alanlar:\n" . implode("\n", $satirlar);
}
Katman 2: yanıttan JSON'u ayıklayın
Talimata rağmen model kod bloğu ekleyebilir. Bunu hata saymak yerine tolere etmek daha ucuzdur.
function jsonAyikla(string $ham): ?array
{
    $metin = trim($ham);

    // ```json ... ``` sarmalayıcısını temizle
    if (preg_match('/```(?:json)?\s*(.+?)```/s', $metin, $m) === 1) {
        $metin = trim($m[1]);
    }

    // Baştaki/sondaki açıklama cümlelerini at: ilk { ile son } arasını al
    $bas = strpos($metin, '{');
    $son = strrpos($metin, '}');
    if ($bas === false || $son === false || $son < $bas) {
        return null;
    }

    $veri = json_decode(substr($metin, $bas, $son - $bas + 1), true);

    return is_array($veri) ? $veri : null;
}
Modelden gelen ham yanıtı bir olay günlüğüne yazmak, sonradan hata ayıklamayı belirgin biçimde kolaylaştırır.
Katman 3: doğrulama
JSON'un ayrıştırılabilir olması, doğru olduğu anlamına gelmez. Alan tipleri ve zorunluluklar ayrıca kontrol edilmelidir — bu, modelin uydurduğu bir enum değerinin veritabanına yazılmasını engeller.
function semayaGoreDogrula(array $veri, array $sema): array
{
    $hatalar = [];

    foreach ($sema as $alan => $k) {
        $var = array_key_exists($alan, $veri);

        if (! $var) {
            if ($k['zorunlu']) {
                $hatalar[] = "'{$alan}' alanı eksik.";
            }
            continue;
        }

        $deger = $veri[$alan];

        if ($k['tip'] === 'enum' && ! in_array($deger, $k['degerler'], true)) {
            $hatalar[] = "'{$alan}' değeri geçersiz: " . var_export($deger, true);
        }
        if ($k['tip'] === 'string' && ! is_string($deger)) {
            $hatalar[] = "'{$alan}' metin olmalı.";
        }
        if ($k['tip'] === 'array' && ! is_array($deger)) {
            $hatalar[] = "'{$alan}' dizi olmalı.";
        }
        if (isset($k['maks']) && is_string($deger) && mb_strlen($deger) > $k['maks']) {
            $hatalar[] = "'{$alan}' en fazla {$k['maks']} karakter olmalı.";
        }
    }

    return $hatalar;
}
Katman 4: tek turluk onarım
Doğrulama başarısızsa hatayı modele geri bildirip bir kez düzeltme isteyin. Sınırsız döngü kurmak maliyeti patlatır ve gecikmeyi öngörülemez yapar.
function yapilandirilmisIste(LlmIstemci $llm, string $girdi, array $sema): ?array
{
    $istek  = semaMetni($sema) . "\n\nMetin:\n" . $girdi;
    $yanit  = $llm->uret($istek, ['temperature' => 0.1]);   // düşük sıcaklık = kararlı yapı
    $veri   = jsonAyikla($yanit);
    $hatalar = $veri === null ? ['Yanıt geçerli JSON değil.'] : semayaGoreDogrula($veri, $sema);

    if (! $hatalar) {
        return $veri;
    }

    // Tek onarım turu: hatayı açıkça söyle
    $onarim = $istek . "\n\nÖnceki yanıtın şu hataları içeriyordu:\n- "
        . implode("\n- ", $hatalar) . "\nYalnızca düzeltilmiş JSON'u döndür.";

    $veri = jsonAyikla($llm->uret($onarim, ['temperature' => 0.0]));

    return ($veri !== null && ! semayaGoreDogrula($veri, $sema)) ? $veri : null;
}
Yapılandırılmış çıktı isterken sıcaklığı düşük tutun (0,0–0,2). Yaratıcılık burada bir özellik değil, hata kaynağıdır.
Model çıktısını içerik üretiminde kullanıyorsanız, sonucun makinelerce doğru yorumlanması için yapılandırılmış veri eklemeyi de planlayın.
Maliyet ve güvenlik notu
Her onarım turu ikinci bir çağrı demektir; bu yüzden onarım oranını ölçün. Oran %10'un üzerindeyse sorun modelde değil şema tanımınızda olabilir. Maliyet tarafındaki diğer kaldıraçları LLM maliyetini düşürme yazımızda toplamıştık. Modelin ürettiği içeriğin doğruluğu ayrı bir konudur; halüsinasyonu azaltma ve RAG mimarisi yazıları bu tarafı tamamlar. Sağlayıcıların yapılandırılmış çıktı desteği için Gemini yapılandırılmış çıktı belgeleri güncel bir referanstır.
Sonuç
Model çıktısını doğrudan kullanmak, kullanıcıdan gelen veriyi doğrulamadan kaydetmekle aynı kategoridedir. Dört katman bu riski yönetilebilir kılar: şemayı isteğin içine koyun, yanıttan JSON'u toleranslı biçimde ayıklayın, alan bazında doğrulayın ve yalnızca bir onarım turu tanıyın. İkinci turda da başarısızsa güvenli bir varsayılana düşün ve bunu günlüğe yazın. Bir sonraki yapay zekâ entegrasyonunuzda "model genelde doğru döndürüyor" cümlesini duyduğunuzda, o "genelde"nin yüzde kaç olduğunu ölçmekle işe başlayın.
Sık sorulan sorular
Sağlayıcının kendi "JSON modu" varken bu katmanlar gerekli mi?
JSON modu ayrıştırma hatalarını büyük ölçüde bitirir, ama alan doğruluğunu garanti etmez: model geçerli JSON içinde geçersiz bir enum değeri veya boş bir zorunlu alan döndürebilir. Doğrulama katmanı her koşulda kalmalıdır.
Onarım turu maliyeti ikiye katlamaz mı?
Yalnızca başarısız isteklerde ikinci bir çağrı yapılır. Onarım oranı düşükse toplam maliyet artışı yüzde birkaç seviyesinde kalır. Oran yüksekse asıl çözüm şemayı sadeleştirmek ve örnek çıktı vermektir, tur sayısını artırmak değil.
Şemayı çok ayrıntılı yazmak zararlı olur mu?
Aşırı uzun şema tanımı hem bağlam maliyeti yaratır hem de modelin dikkatini dağıtır. Pratik denge: yalnızca gerçekten kullanacağınız alanları isteyin ve her alana tek satırlık açıklama koyun.
Doğrulama başarısız olduğunda kullanıcıya ne göstermeli?
Teknik hatayı değil, anlamlı bir geri dönüş gösterin: örneğin otomatik özet üretilemediyse alanı boş bırakıp kullanıcıya elle doldurma imkânı verin. Sessizce bozuk veri kaydetmek en kötü seçenektir; hatayı günlüğe yazıp görünür kılmak şarttır.
Yazan
Çılgın Yazılım
Ben Evren Çılgın; yazılım geliştirme, web teknolojileri ve sistem tasarımı alanlarında uzmanlaşmış bir geliştiriciyim. Uzun yıllardır hem frontend hem de backend tarafında üretken, ölçeklenebilir ve kullanıcı dostu çözümler üretiyorum.
Bu konuda bir projeniz mi var?
İhtiyacınızı birkaç cümleyle anlatın; uygun yaklaşımı birlikte belirleyelim.
İlgili yazılar


Yorumlar
Henüz yorum yok. Sorunuzu ya da deneyiminizi ilk siz yazın.
Yorum yazın
Yorumunuz onaylandıktan sonra yayınlanır. Ekibimiz gerekirse konuyla ilgili bir yanıt da paylaşır.