
Yapay Zekâ ve Veri kod örnekli
Çapraz Doğrulamada Zaman Sızıntısı: Neden Modeliniz Testte Parlıyor?
Rastgele katlara bölmek zaman serisinde geleceği geçmişe sızdırır. Model testte mükemmel, üretimde vasat olur.
 Çılgın Yazılım
4 dk okuma

İçindekiler
Çapraz doğrulama, modelin görmediği veri üzerindeki başarısını tahmin etmek için kullanılır. Standart k-katlı yöntem çoğu problemde doğru çalışır — ancak veriniz zamana bağlıysa aynı yöntem sistematik olarak yanıltır ve gerçekte olmayan bir başarıyı raporlar.
Sorun: geleceği geçmişe sızdırmak
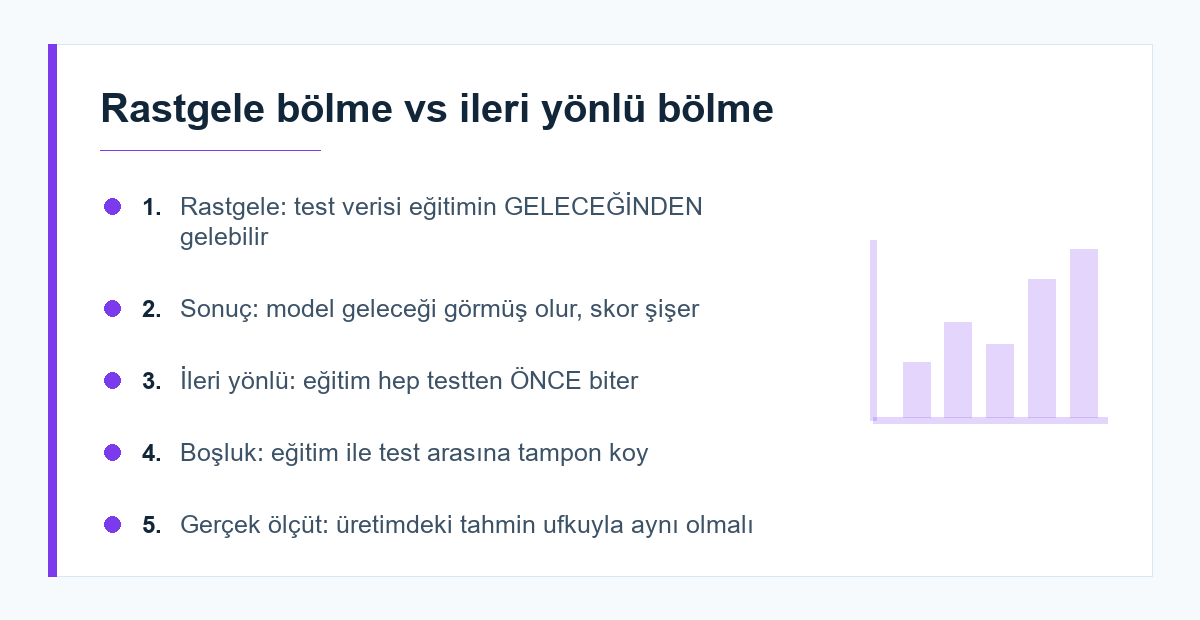
Rastgele bölme, Mart ayına ait bir kaydı eğitim setine, Şubat ayına ait bir kaydı test setine koyabilir. Model Mart'ı görerek Şubat'ı tahmin eder. Üretimde böyle bir imkân yoktur: gelecek henüz yaşanmamıştır. Sonuç, testte %94 doğrulukla parlayan ve canlıda %71'e düşen bir modeldir.
# YANLIŞ: zaman bilgisini yok sayar
from sklearn.model_selection import cross_val_score, KFold

skor = cross_val_score(model, X, y, cv=KFold(n_splits=5, shuffle=True))
print(skor.mean())   # İyimser ve GERÇEK DIŞI bir sayı
Doğru yöntem: ileri yönlü bölme
Zaman serisinde her kat, eğitimin testten önce bittiği bir pencere olmalıdır. scikit-learn bunu doğrudan sunar.
from sklearn.model_selection import TimeSeriesSplit
import numpy as np

# Veriyi zamana göre SIRALADIĞINIZDAN emin olun
df = df.sort_values("tarih").reset_index(drop=True)
X, y = df[ozellikler].values, df["hedef"].values

tscv = TimeSeriesSplit(n_splits=5, test_size=30)   # her katta 30 günlük test

skorlar = []
for kat, (egitim_idx, test_idx) in enumerate(tscv.split(X), start=1):
    model.fit(X[egitim_idx], y[egitim_idx])
    skor = model.score(X[test_idx], y[test_idx])
    skorlar.append(skor)
    print(f"kat {kat}: egitim={len(egitim_idx):5d}  test={len(test_idx):3d}  skor={skor:.3f}")

print("ortalama:", np.mean(skorlar).round(3), "std:", np.std(skorlar).round(3))
Katlar arası standart sapmaya dikkat edin. Yüksek sapma, modelin belirli dönemlerde çalışıp diğerlerinde çöktüğünü gösterir — ortalama tek başına bunu gizler.
Boşluk (gap) bırakmak
Özelliklerinizde hareketli ortalama gibi geçmişe bakan hesaplar varsa, eğitim setinin son günü ile test setinin ilk günü arasında bir tampon bırakmalısınız. Aksi hâlde test gününün bilgisi, eğitim penceresindeki bir özelliğin içine sızar.
tscv = TimeSeriesSplit(n_splits=5, test_size=30, gap=7) # 7 günlük tamponÖlçekleme ve doldurma (imputation) işlemlerini tüm veri üzerinde önceden yapmak da bir sızıntıdır: test setinin ortalaması eğitim dönüşümüne karışır. Bu adımları mutlaka Pipeline içine koyun ki her katta yalnızca eğitim verisiyle uydurulsunlar.
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

boru = Pipeline([
    ("olcek", StandardScaler()),      # her katta SADECE eğitim verisiyle fit edilir
    ("model", model),
])
Model çıktısını bir uygulamaya bağlıyorsanız yanıtın yapısını da doğrulamanız gerekir; LLM çıktısını şemaya zorlamak yazımız bu katmanı anlatıyor.
Grup sızıntısı: aynı varlık iki tarafta
Zaman dışında ikinci bir sızıntı türü daha vardır: aynı müşterinin farklı kayıtlarının hem eğitimde hem testte bulunması. Model müşteriyi ezberler, genelleme ölçümü bozulur. Çözüm GroupKFold veya zamanla birlikte grup bazlı bölmedir. Bu ve benzeri tuzakları özellik mühendisliğinde veri sızıntısı yazımızda ayrıntılı ele almıştık.
Kullanacağınız kütüphanenin üretime hazır olup olmadığını değerlendirmek için olgunluk işaretleri listemiz işe yarar.
Metrik seçimi de aynı derecede önemli
Doğru bölme yaptığınız hâlde yanlış metrik kullanırsanız yine yanılırsınız. Nadir bir olayı tahmin ediyorsanız doğruluk (accuracy) neredeyse anlamsızdır; bu konuyu dengesiz veri setinde doğruluk neden yanıltır yazımızda ele aldık. Ayrıca model canlıya çıktıktan sonra veri dağılımı değişebilir — üretimde veri kayması bu sürecin izlenmesini anlatıyor. Yöntemlerin resmî anlatımı için scikit-learn çapraz doğrulama belgeleri kapsamlı bir kaynaktır.
Sonuç
Doğrulama şemanız, modelin üretimde içinde bulunacağı durumu taklit etmiyorsa ölçtüğünüz sayı bir tahmin değil, bir temennidir. Zamana bağlı veride rastgele katlardan kaçının, ileri yönlü bölme kullanın, geçmişe bakan özellikler varsa tampon bırakın, ön işleme adımlarını boru hattına alın ve aynı varlığın iki tarafa dağılmadığından emin olun. Bir sonraki modelinizde testte çıkan skoru raporlamadan önce tek bir soru sorun: "Bu modeli o tahmini yaparken hangi bilgiye sahiptim?" Cevap doğrulama şemanızla örtüşmüyorsa, ölçümü baştan kurun.
Pratik Uygulama Kontrol Listesi
Bu yazıdaki önerileri kendi ekibinize uyarlarken aşağıdaki adımları sırasıyla uygulamanız, teoriden pratiğe geçişi kolaylaştırır:
- Mevcut durumu ölçün. Değişiklik yapmadan önce bugünkü performansı/süreyi/hata oranını kaydedin; aksi halde iyileşmeyi kanıtlayamazsınız.
- Küçük bir pilot seçin. Tüm sisteme veya tüm ekibe birden uygulamak yerine tek bir modülde veya tek bir sprintte deneyin.
- Sonuçları ekiple paylaşın. Elde ettiğiniz veriyi (olumlu ya da olumsuz) kısa bir notla ekibe aktarın; kararın gerekçesi belgelenmemişse aynı tartışma birkaç ay sonra tekrar açılır.
- Süreci tekrarlanabilir hale getirin. İşe yarayan pratiği bir kontrol listesine veya şablona dönüştürün ki yeni katılan ekip üyeleri de aynı standardı hızlıca öğrensin.
Çapraz Doğrulama konusunda attığınız her küçük adım ölçülebilir olduğu sürece değerlidir; büyük ve tek seferlik dönüşümler yerine sürekli, küçük iyileştirmeler uzun vadede daha kalıcı sonuç verir.
Sık Yapılan Yanlışlar
Bu konuda ekiplerin en çok düştüğü tuzak, çözümü tek bir kişiye ya da tek bir araca yüklemektir. Oysa kalıcı iyileşme, sürecin ekibin günlük rutinine (code review kontrol listesi, sprint planlama, onboarding dokümanı gibi) gömülmesiyle mümkün olur. İkinci yaygın hata ise "en iyi pratiği" olduğu gibi kopyalamaktır — başka bir ekipte işe yarayan bir yaklaşım, farklı bir ölçekte veya farklı bir teknoloji yığınında aynı sonucu vermeyebilir; önce kendi bağlamınızda küçük ölçekte test edin, sonra genişletin. Üçüncü tuzak ise ölçmeden karar vermektir: "daha iyi hissettiriyor" öznel bir gerekçedir, ekip içi tartışmalarda nesnel veriyle desteklenmeyen kararlar er ya da geç sorgulanır ve geri alınır. Son olarak, dokümantasyonu atlamak da sık görülen bir hatadır: bir kararın "neden" alındığı yazılı değilse, ekip altı ay sonra aynı tartışmayı sıfırdan yeniden yapmak zorunda kalır ve önceki deneyimden öğrenilenler kaybolur.
Sonuç
Çapraz Doğrulamada Zaman Sızıntısı: Neden Modeliniz Testte Parlıyor? konusunda burada değindiğimiz noktalar, konuyu ilk kez ele alan ekipler için de deneyimli geliştiriciler için de pratik bir kontrol listesi görevi görür. çapraz doğrulama üzerine çalışırken en çok fayda sağlayan yaklaşım, tek seferde her şeyi mükemmelleştirmeye çalışmak yerine küçük, ölçülebilir adımlarla ilerlemektir. Ekibinizde bu konuyu bir sonraki sprint retrospektifinde veya teknik tartışma toplantısında gündeme getirmenizi, burada anlatılan pratiklerden hangilerinin sizin bağlamınıza uyduğunu birlikte değerlendirmenizi öneririz. Sonuç olarak, doğru araçları seçmek kadar bunları ekip kültürüne oturtmak da başarıyı belirleyen asıl etkendir.
Sık sorulan sorular
Verim zaman içeriyor ama tahmin geleceğe dönük değil; yine de ileri yönlü bölme gerekli mi?
Karar ölçütü tahmin anıdır. Model üretimde geçmiş ve gelecek kayıtların hepsine erişebiliyorsa rastgele bölme meşrudur. Ama modelin çalıştığı anda gelecek kayıtlar henüz yoksa, ileri yönlü bölme zorunludur.
TimeSeriesSplit ile kaç kat kullanmalıyım?
Veri uzunluğuna bağlıdır. Her katın testinde anlamlı bir örneklem kalmalı ve ilk katın eğitim penceresi modelin öğrenmesine yetmelidir. Pratikte 3-5 kat çoğu senaryo için dengelidir; daha fazlası ilk katları aşırı küçültür.
Katlar arası skor farkı yüksekse ne yapmalıyım?
Bu genelde mevsimsellik veya rejim değişikliği işaretidir. Önce hangi dönemin kötü olduğunu bulun, sonra o döneme özgü bir özellik (tatil, kampanya, dönem göstergesi) ekleyip ekleyemeyeceğinize bakın. Ortalamayı raporlayıp geçmek, üretimdeki kötü dönemi görünmez kılar.
Ölçekleme adımını neden boru hattına almak zorundayım?
Ölçekleyiciyi tüm veri üzerinde eğitirseniz, test setinin ortalaması ve standart sapması dönüşüme karışır. Bu, küçük ama sistematik bir iyimserlik yaratır. Boru hattı, her katta dönüşümün yalnızca eğitim verisiyle uydurulmasını garanti eder.
Yazan
Çılgın Yazılım
Ben Evren Çılgın; yazılım geliştirme, web teknolojileri ve sistem tasarımı alanlarında uzmanlaşmış bir geliştiriciyim. Uzun yıllardır hem frontend hem de backend tarafında üretken, ölçeklenebilir ve kullanıcı dostu çözümler üretiyorum.
Bu konuda bir projeniz mi var?
İhtiyacınızı birkaç cümleyle anlatın; uygun yaklaşımı birlikte belirleyelim.
İlgili yazılar


Yorumlar
Henüz yorum yok. Sorunuzu ya da deneyiminizi ilk siz yazın.
Yorum yazın
Yorumunuz onaylandıktan sonra yayınlanır. Ekibimiz gerekirse konuyla ilgili bir yanıt da paylaşır.